出身大学か出身県が同じ学生のグループ化ってどうやるんだっけの考察メモ(ひとまずPython)
はじめに
グループ化の演算の要件で、出身大学と出身県が同じ学生どうしをグループ化というのは良くある話だと思います。
しかし、
同じようなグループ化の例でも、出身大学か出身県が同じ学生のグループ化となると一気にハードルが上がりそうな気がします。
競プロ等に親しんでいる方らからすると初歩レベルの問題かもしれませんが、いややっぱり結構面白いのではと思い、うんうんうなって考察した結果、面白いかはともかく それほど難しくもない方式で実現できて、逆に落とし穴がないかさらしてみたくなったので、その結果のスニペットを貼り付けてみた...という投稿です。

インプットデータを一巡通過するまではグループ自体が確定しないというところが面白いと感じています。
アイディア
2つのワーク変数(ループのその時点の「分類実績」を格納する「2次元配列」のデータとこの配列の何個目のグループにより分けられているかの「索引」を保持するデータ)を使います。
なお、出身大学が違っても出身県が一緒なら、逆に出身県が違っても出身大学が同じならという繋がっていく関係を「トラバース」と呼びました。

Pythonでのプログラム例
一旦、グループ自体の炙り出しを行うところまでです。 なお、万能ではないものの「性能」という意味では、ハッシュ系の「型」は"速い"傾向があるというところをアテにしたものになっています。
import copy
def teamgrouping(listoftokens):
    teams =[] # チーム名簿
    tn = {}  # チーム所属台帳 TeamNumber: あるトークンの所属チーム番号(temasのインデックス値)の辞書
    for _tokens in listoftokens:
        tokens = copy.copy(_tokens)
        # 関連するチームを炙り出す ( TeamNoのリスト→ tnlist )
        tnlst = sorted(list(set([ tn[t] for t in tokens if t in tn ])))
        # 既存の関連チームの有無を考慮しながらグループ化・再編を実施
        l = len(tnlst)
        if l == 0: # 既存なしのため、新チーム結成〜名簿に登録
            teams.append(tokens)
            idx = len(teams) - 1
        if l == 1: # 既存チームに合流
            idx = tnlst[0]
            teams[idx] += tokens
        if l >= 2: # 最古参のチームに合流し、これを媒介とする他のチームもマージする
            idx = tnlst[0]
            # 新たなメンバを最古参のチームに合流させる
            teams[idx] += tokens
            # 既存のメンバも最古参のチームに合流させる
            for _i in tnlst[1:]:
                for _t in teams[_i]:
                    tn[_t] = idx
                teams[idx] += teams[_i]
                teams[_i] = [] # 役目を終えたので初期化する
        # 台帳を最新化
        for _t in tokens:
            tn[_t] = idx

    return tn,teams

# 動作確認

conf = ['AaBbCcDdEaEbBcFd', #2チーム
    'AaBbCcDdEaEbBcFdDa', #結果的に1チームにまとまる
    '東e西w南s北nEeEn'
]

for c in conf:
    a = list(c)
    aa = [[i,j] for i,j in zip(a[0::2],a[1::2])]
    tn,teams = teamgrouping(aa)
    print('')
    print(aa)
    print(tn)
    print( [sorted(set(t)) for t in teams])
    print('')
思考実験とはいえ、変数名などはもう少し整理した方がよかったかなと思いつつ、それ以外のところでは、もしもっと掘り下げるなら 以下を整備した方が良いかなという自分メモ
- l ==1と l >=2 あたりは、もう少し、早期リターン(continue)に寄せると、見通しがよくなりそう。
- tnのアップデートをローカル関数にした方がアルゴリズムの意図は明確になる気がする。
- リストの結合としているが、set(集合)の演算にした方が良い。場当たり的に import copy をしているが、それも必要なくなる。
ElasticsearchのAggregations(nested,reverse_nested,parent,children)の例
はじめに
ElasticsearchのAggregationsのnested,reverse_nested,parent,childrenについては次の過去記事ではごまかして説明をスキップしたので、あらためてまとめてみました。
まとめてみた... と言っても、公式の例を筆者なりに噛み砕いた例におきかえただけですので悪しからず。
なぜこの4つか
...というほど大げさな話ではないものの、Bucket Aggregationsに所属するこの4つのAggsですが、実際のところ、同じBucket Aggregationsの最も定番かなと思われるtermsクエリと実際はほぼ一緒と言えると思います。
じゃあ、ほぼ一緒じゃない部分はどこかというと、termsはいくつかあるElasticsearchの基本的なデータタイプをターゲットにしているのに対し、この4つはnested、join(parent,children)というRDBでは苦手(というと語弊があるかもしれませんがひとまず)な検索エンジンおもしろじゃんという変わった型を扱うところが違います。
まあ、つまるところ、これらの型についてもterms Aggが使えるように拡張されたクエリととらえて良いのではないでしょうか。
Nested field type | Elasticsearch Guide [master] | Elastic
Join field type | Elasticsearch Guide [master] | Elastic
なお、この記事はElasticsearch ver 6.8 で確認して記述しました。ただし、ここで記述した範囲のことの本質は ver 7系でも変わっていないと思います。(違ったらごめんなさい)
ためしてみる
(1)nested, reverse_nested
ある製品種別に対して、取り扱い業者(販売業者ということにしました)がA、B、...のようにいて、業者には担当者がいるとしたデータを考えます。 また、販売業者ごとに同じ製品種別でも販売価格が違うこととします。
nestedデータの仕込み
PUT /products?include_type_name=false
{
  "mappings": {
    "properties": {
      "resellers": {
        "type": "nested",
        "properties": {
          "reseller": { "type": "keyword" },
          "staff":{"type":"keyword"},
          "price": { "type": "double" }
        }
      }
    }
  }
}
PUT /products/_doc/0
{
  "name": "LED TV",
  "n":"エルイーディーテレビ",
  "resellers": [
    {
      "reseller": "companyA",
      "staff": "Hachimura-San",
      "price": 350
    },
    {
      "reseller": "companyB",
      "staff": "Ohtani-San",
      "price": 500
    }
  ]
}

PUT /products/_doc/1
{
  "name": "dryer",
  "n":"ドライヤー",
  "resellers": [
    {
      "reseller": "companyA",
      "staff": "Ohsaka-San",
      "price": 50
    },
    {
      "reseller": "companyB",
      "staff": "Ohtani-San",
      "price": 65
    },
        {
      "reseller": "companyC",
      "staff": "Nishigori-San",
      "price": 65
    }
  ]
}
製品情報に対して、これを取り扱う販売業者の情報を直接保持するというデータをある種自然な形で保持できるというところがポイントですね。 (JSON的には、オブジェクトの配列で保持されているところに注目)
(A)nested Agg
うまくいかない例
nested Aggの文法例を示す前に、あえてうまくいかない例を示します。
nested データタイプとかどうとかはひとまず考えず、Elasticsearchには、resellers.resellerみたいなドットで区切ってフィールドを指定できるパターンがあります。
常にうろ覚えの筆者のようなヒトだと次のようなクエリでいけそうな気がするのです。
GET /products/_search
{
  "size":0,
  "aggs": {
    "製品種別ごとの": {
      "terms": {
        "field": "name.keyword"
      },
      "aggs": {
        "について、販売業者の一覧": {
          "terms": {
            "field": "resellers.reseller"
          }
        }
      }
    }
  }
}
が、結果としては次のようになりそれらしき値は取得できません。
{
  "aggregations" : {
    "製品種別ごとの" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "LED TV",
          "doc_count" : 1,
          "について、販売業者の一覧" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [ ]
          }
        },
        {
          "key" : "dryer",
          "doc_count" : 1,
          "について、販売業者の一覧" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [ ]
          }
        }
      ]
    }
  }
}
nested を使った動作する例1
nested型のフィールドにはおまじないが必要です。
GET /products/_search
{
  "size":0,
  "aggs": {
    "製品種別ごとの": {
      "terms": {
        "field": "name.keyword"
      },
      "aggs": {
        "について、販売業者の一覧": {
          "nested": {
            "path": "resellers"
          },
          "aggs": {
            "名前": {
              "terms": {
                "field": "resellers.reseller"
              }
            }
          }
        }
      }
    }
  }
}
クエリの結果↓
{
  "aggregations" : {
    "製品種別ごとの" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "LED TV",
          "doc_count" : 1,
          "について、販売業者の一覧" : {
            "doc_count" : 2,
            "名前" : {
              "doc_count_error_upper_bound" : 0,
              "sum_other_doc_count" : 0,
              "buckets" : [
                {
                  "key" : "companyA",
                  "doc_count" : 1
                },
                {
                  "key" : "companyB",
                  "doc_count" : 1
                }
              ]
            }
          }
        },
        {
          "key" : "dryer",
          "doc_count" : 1,
          "について、販売業者の一覧" : {
            "doc_count" : 3,
            "名前" : {
              "doc_count_error_upper_bound" : 0,
              "sum_other_doc_count" : 0,
              "buckets" : [
                {
                  "key" : "companyA",
                  "doc_count" : 1
                },
                {
                  "key" : "companyB",
                  "doc_count" : 1
                },
                {
                  "key" : "companyC",
                  "doc_count" : 1
                }
              ]
            }
          }
        }
      ]
    }
  }
}
nested を使った動作する例2
nestedを間に挟めば、Metrics aggregationも使えます。 最安価格をチョイスします。
GET /products/_search
{
  "size":0,
  "aggs": {
    "製品種別ごとの": {
      "terms": {
        "field": "name.keyword"
      },
      "aggs": {
        "について、販売業者の一覧": {
          "nested": {
            "path": "resellers"
          },
          "aggs": {
            "最安価格": {
              "min": {
                "field": "resellers.price"
              }
            }
          }
        }
      }
    }
  }
}
クエリの結果↓
{
  "aggregations" : {
    "製品種別ごとの" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "LED TV",
          "doc_count" : 1,
          "について、販売業者の一覧" : {
            "doc_count" : 2,
            "最安価格" : {
              "value" : 350.0
            }
          }
        },
        {
          "key" : "dryer",
          "doc_count" : 1,
          "について、販売業者の一覧" : {
            "doc_count" : 3,
            "最安価格" : {
              "value" : 50.0
            }
          }
        }
      ]
    }
  }
}
(B)reverse nested Agg
つづいてreverse_nested です。
こちらは、nestedを下敷きに、nested内にある、ある値を持つドキュメントをトップレベルの値のバリエーションでグループ化できるというやつです。
(販売業者の)各担当者がどの製品を担当しているかといったことを先述のドキュメントから抽出するのが次のreverse_nestedを使ったクエリです。
GET /products/_search
{
  "size": 0,
  "aggs": {
    "(販売業者)": {
      "nested": {
        "path": "resellers"
      },
      "aggs": {
        "担当者が": {
          "terms": {
            "field": "resellers.staff"
          },
          "aggs": {
            "どの製品を担当しているか": {
              "reverse_nested": {},
              "aggs": {
                "___": {
                  "terms": {
                    "field": "name.keyword"
                  }
                }
              }
            }
          }
        }
      }
    }
  }
}
↑クエリ構造としては、aggsの4階層なのですが、3階層目に「reverse_nested:{}」のおまじないを入れることで、4階層目にあるドキュメントのトップに定義されているフィールドであるnameを使ってドキュメント全体をバケットにグループ分けできる...という理解でいいと思います。 ↓ 検索結果です。
{
  "aggregations" : {
    "(販売業者)" : {
      "doc_count" : 5,
      "担当者が" : {
        "doc_count_error_upper_bound" : 0,
        "sum_other_doc_count" : 0,
        "buckets" : [
          {
            "key" : "Ohtani-San",
            "doc_count" : 2,
            "どの製品を担当しているか" : {
              "doc_count" : 2,
              "___" : {
                "doc_count_error_upper_bound" : 0,
                "sum_other_doc_count" : 0,
                "buckets" : [
                  {
                    "key" : "LED TV",
                    "doc_count" : 1
                  },
                  {
                    "key" : "dryer",
                    "doc_count" : 1
                  }
                ]
              }
            }
          },
          {
            "key" : "Hachimura-San",
            "doc_count" : 1,
            "どの製品を担当しているか" : {
              "doc_count" : 1,
              "___" : {
                "doc_count_error_upper_bound" : 0,
                "sum_other_doc_count" : 0,
                "buckets" : [
                  {
                    "key" : "LED TV",
                    "doc_count" : 1
                  }
                ]
              }
            }
          },
          {
            "key" : "Nishigori-San",
            "doc_count" : 1,
            "どの製品を担当しているか" : {
              "doc_count" : 1,
              "___" : {
                "doc_count_error_upper_bound" : 0,
                "sum_other_doc_count" : 0,
                "buckets" : [
                  {
                    "key" : "dryer",
                    "doc_count" : 1
                  }
                ]
              }
            }
          },
          {
            "key" : "Ohsaka-San",
            "doc_count" : 1,
            "どの製品を担当しているか" : {
              "doc_count" : 1,
              "___" : {
                "doc_count_error_upper_bound" : 0,
                "sum_other_doc_count" : 0,
                "buckets" : [
                  {
                    "key" : "dryer",
                    "doc_count" : 1
                  }
                ]
              }
            }
          }
        ]
      }
    }
  }
}
(2)join系(parent,children)
join系(parent,children)の例です。
join系データの仕込み
まず、joinタイプを使ったデータを仕込みます。
公式の「stack overflow」風の例を少し置き換えた、以下のようなデータを仕込みます。 (親となる質問ドキュメント(Q)と子となる回答ドキュメント("ANSWER"でラベリング&親のドキュメントIDを指定))から構成されます。)
PUT cp_example?include_type_name=false
{
  "mappings": {
    "properties": {
      "join": {
        "type": "join",
        "relations": {
          "Q": "ANSWER"
        }
      }
    }
  }
}
PUT cp_example/_doc/1
{
  "join": {
    "name": "Q"
  },
  "body": "Windows2003とWindows2008の話です...",
  "title": "ファイルの転送",
  "TAGS": [
    "WIN2003",
    "WIN2008",
    "FTP"
  ]
}

PUT cp_example/_doc/2?routing=1
{
  "join": {
    "name": "ANSWER",
    "parent": "1"
  },
  "OWNER": "太郎",
  "body": "WinでFTPはやめた方が...",
  "creation_date": "2009-05-04T13:45:37.030"
}

PUT cp_example/_doc/3?routing=1
{
  "join": {
    "name": "ANSWER",
    "parent": "1"
  },
  "OWNER": "花子",
  "body": "Linuxを使え...",
  "creation_date": "2009-05-05T13:45:37.030"
}

PUT cp_example/_doc/4?routing=1
{
  "join": {
    "name": "ANSWER",
    "parent": "1"
  },
  "OWNER": "花子",
  "body": "macはLinuxではない。BSDは...",
  "creation_date": "2009-05-05T13:46:01.021"
}
(C)childrenと(D)parent
以下、childrenとparentをまとめて例示します。
各タグに関して、回答者の一覧とその回答投稿数を"children"を使って取得します。 また、回答者ごとの回答をおこなった質問のタグ(分野)の一覧を"parent"を使って取得します。
(やりたいことが対照的になっていることと、それに合わせて実際のクエリのカタチもchildren、parentを境に反転したイメージになっていることにご注目ください。)
POST cp_example/_search?size=0
{
  "aggs": {
    "TAGS": {
      "terms": {
        "field": "TAGS.keyword",
        "size": 10
      },
      "aggs": {
        "というタグの質問への": {
          "children": {
            "type" : "ANSWER"
          },
          "aggs": {
            "回答者、その回答投稿数": {
              "terms": {
                "field": "OWNER.keyword",
                "size": 10
              }
            }
          }
        }
      }
    }
  }
}
POST cp_example/_search?size=0
{
  "aggs": {
    "OWNERS": {
      "terms": {
        "field": "OWNER.keyword",
        "size": 10
      },
      "aggs": {
        "という人の": {
          "parent": {
            "type" : "ANSWER"
          },
          "aggs": {
            "答えている質問のタグ(分野)の一覧": {
              "terms": {
                "field": "TAGS.keyword",
                "size": 10
              }
            }
          }
        }
      }
    }
  }
}
↓クエリの結果(children)
{
  "aggregations" : {
    "TAGS" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "FTP",
          "doc_count" : 1,
          "というタグの質問への" : {
            "doc_count" : 3,
            "回答者、その回答投稿数" : {
              "doc_count_error_upper_bound" : 0,
              "sum_other_doc_count" : 0,
              "buckets" : [
                {
                  "key" : "花子",
                  "doc_count" : 2
                },
                {
                  "key" : "太郎",
                  "doc_count" : 1
                }
              ]
            }
          }
        },
        {
          "key" : "WIN2003",
          "doc_count" : 1,
          "というタグの質問への" : {
            "doc_count" : 3,
            "回答者、その回答投稿数" : {
              "doc_count_error_upper_bound" : 0,
              "sum_other_doc_count" : 0,
              "buckets" : [
                {
                  "key" : "花子",
                  "doc_count" : 2
                },
                {
                  "key" : "太郎",
                  "doc_count" : 1
                }
              ]
            }
          }
        },
        {
          "key" : "WIN2008",
          "doc_count" : 1,
          "というタグの質問への" : {
            "doc_count" : 3,
            "回答者、その回答投稿数" : {
              "doc_count_error_upper_bound" : 0,
              "sum_other_doc_count" : 0,
              "buckets" : [
                {
                  "key" : "花子",
                  "doc_count" : 2
                },
                {
                  "key" : "太郎",
                  "doc_count" : 1
                }
              ]
            }
          }
        }
      ]
    }
  }
}
↓クエリの結果(parent)
{
  "aggregations" : {
    "OWNERS" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "花子",
          "doc_count" : 2,
          "という人の" : {
            "doc_count" : 1,
            "答えている質問のタグ(分野)の一覧" : {
              "doc_count_error_upper_bound" : 0,
              "sum_other_doc_count" : 0,
              "buckets" : [
                {
                  "key" : "FTP",
                  "doc_count" : 1
                },
                {
                  "key" : "WIN2003",
                  "doc_count" : 1
                },
                {
                  "key" : "WIN2008",
                  "doc_count" : 1
                }
              ]
            }
          }
        },
        {
          "key" : "太郎",
          "doc_count" : 1,
          "という人の" : {
            "doc_count" : 1,
            "答えている質問のタグ(分野)の一覧" : {
              "doc_count_error_upper_bound" : 0,
              "sum_other_doc_count" : 0,
              "buckets" : [
                {
                  "key" : "FTP",
                  "doc_count" : 1
                },
                {
                  "key" : "WIN2003",
                  "doc_count" : 1
                },
                {
                  "key" : "WIN2008",
                  "doc_count" : 1
                }
              ]
            }
          }
        }
      ]
    }
  }
}
ElasticsearchのAggsで「グループ内で最大値をとるレコードを抽出する」風の実現例(邪道流)
はじめに
Elasticsearchでは、SQLでいうところのGROUP BYに近い挙動となるAggregationsというクエリがあります。
ここ何回かの過去記事でもAggregationsをちょいと雑に俯瞰する記事を投稿しました。
なおこのAggregationsですが、GROUP BYに近いというものの、SQLでのGROUP BYと副問い合わせなどを駆使した「グループ内で最大値をとるレコードを抽出する」といったことは(私がモグリで見逃しているだけかもしれませんが)直接的な方法はありません。
検索エンジンの用法・用途としては、無理にこの仕組みはいらないな〜、少なくともその対応のために、新しいクエリのシンタックスを覚えたりするのはめんどくさいな〜と思いつつ、どうしても小手先のワザで済ませたい場合のある手法の一例を共有します。
途中はさみこむワザはやや邪道かもしれませんが、はからずもAggregationsのシンタックスや挙動を深く理解することにもつながるかもしれませんので、記事にしてみた次第です。
考え方
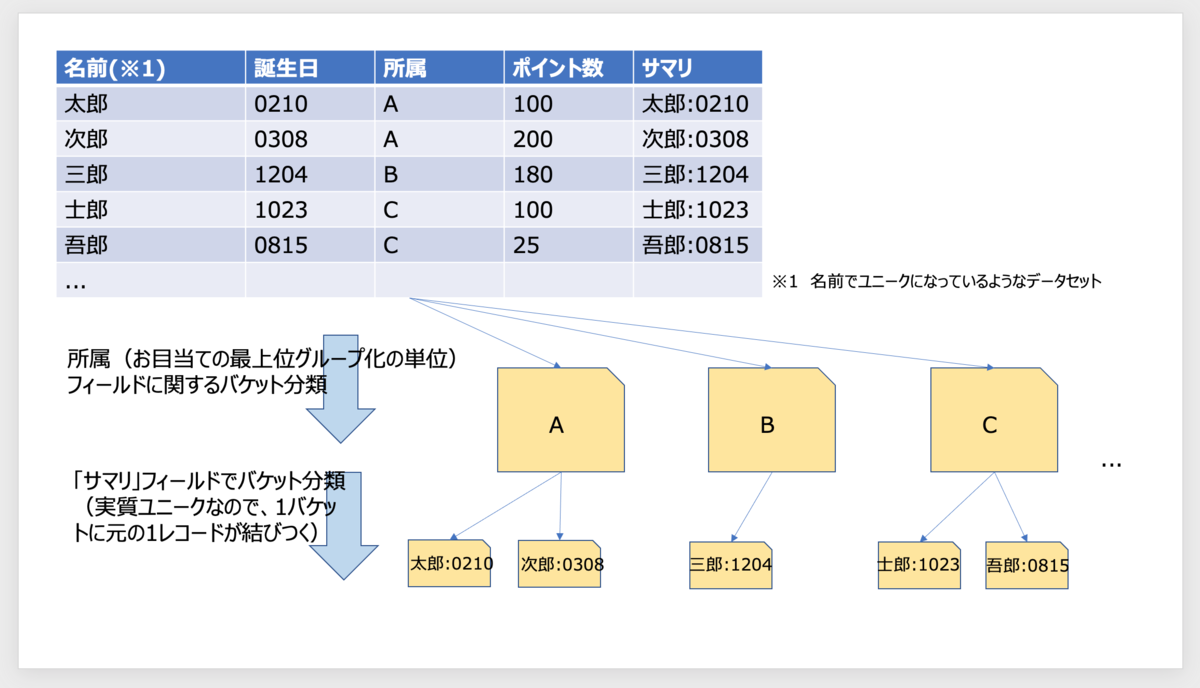
具体的なアイディアの土台としては、次の図のように、「ドキュメントの中にそのドキュメントを象徴する複合項目(図では「サマリ」項目と呼びました)を再掲」しておき、そこにからめて所定のAggregationsをかませる、です。
ま、それでいいなら可能だよなと思った方、ごめんなさい。先に謝っておきます。
お、邪道だけどアリかもと思っていただいた方ありがとうございます。もちろん、いろいろと効率が悪いというか目的外使用の側面はあると思いますので、ご利用時はパフォーマンス含めご注意ください。
なお、サマリ項目と言えば、runtime_mappingという動的にAggregationの対象フィールドを擬似的に生成するオプションが7.x系で追加になっているようです。 もちろん他の用途をイメージしたものだと思いますが、「サマリ」フィールドをインデックス時に考えなくて良いという本手法の選択肢が増えたといえるかもしれません。
本記事は6.8系で確認した都合、runtime_mappingの説明は含めていませんが、そもそも本記事の邪道用途に限らずおもしろい仕掛けなのでご紹介しておきます。
Runtime fields | Elasticsearch Guide [7.13] | Elastic
ということで以下事例です。
- はじめに
- 考え方
- データインポート
- 1. グループごとの擬似レコード一覧(ウォーミングアップ)
- 2. あるフィールド値の合計がある値以上のグループに限定した擬似レコード一覧
- 3. 配下件数が多いグループのみ擬似一覧抽出
- 4. グループごとにグループ配下の擬似レコードと特定フィールドをペアで抜き出し(sumは実際は1件のレコードの合計なので1つの値を抽出)
- 5. グループ内であるフィールド値が最大の擬似レコードを抽出(件名に対応した例)
- 6. グループごとに配下レコードの特定項目の値の降順に並べて値を取得(前項の「sumは実際は1件だけの合計」方式の応用)
- 7. レコードの特定項目の値が特定の値以上のものを取得(グループごとに分類あり)
- 8. 複合クエリも可能
データインポート
ちょっと冗長ですが、以下のデータを入れてみてください。
※直接使うのは、aフィールド、dフィールド、そして上の方で、便宜上「サマリ」フィールドと呼称したものに該当するのが、complフィールドです。
aフィールド(のちの例では「a.keyword」となります)でグループ化すると5グループで、うち4グループは配下に5件、1グループだけ6件となるようなデータ群です。
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "compl": "a10:10:0", "d": 0, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "compl": "a10:10:1", "d": 1, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "compl": "a10:10:2", "d": 2, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "compl": "a10:10:3", "d": 3, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "compl": "a10:10:4", "d": 4, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "compl": "a100:100:1000", "d": 5, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "compl": "a100:100:1001", "d": 6, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "compl": "a100:100:1002", "d": 7, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "compl": "a100:100:1003", "d": 8, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "compl": "a100:100:1004", "d": 9, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "compl": "a1000:1000:2000", "d": 10, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "compl": "a1000:1000:2001", "d": 11, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "compl": "a1000:1000:2002", "d": 12, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "compl": "a1000:1000:2003", "d": 13, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "compl": "a1000:1000:2004", "d": 14, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "compl": "a10000:10000:3000", "d": 15, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "compl": "a10000:10000:3001", "d": 16, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "compl": "a10000:10000:3002", "d": 17, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "compl": "a10000:10000:3003", "d": 18, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "compl": "a10000:10000:3004", "d": 19, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "compl": "a100000:100000:4000", "d": 20, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "compl": "a100000:100000:4001", "d": 21, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "compl": "a100000:100000:4002", "d": 22, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "compl": "a100000:100000:4003", "d": 23, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "compl": "a100000:100000:4004", "d": 24, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "compl": "a100000:100000:9999", "d": 24, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
1. グループごとの擬似レコード一覧(ウォーミングアップ)
GET a_ex/_search?size=0&filter_path=agg*
{
    "aggs": {
        "grp": {
            "terms": {
                "field": "a.keyword"
            },
            "aggs": {
                "c_list": {
                    "terms": {
                        "field": "compl.keyword",
                            "size": 3
                    }
                }
            }
        }
    }
}
結果
aフィールドでグループ化しつつ、実質ユニークなフィールドcomplでサブグループ化するので配下の一覧が得られます。 (ここでは、全件ではなく、(結果的に)DB出現順に3件ずつ取得しています。)
{
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100000",
          "doc_count" : 6,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 3,
            "buckets" : [
              {
                "key" : "a100000:100000:4000",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4001",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4002",
                "doc_count" : 1
              }
            ]
          }
        },
        {
          "key" : "a10",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 2,
            "buckets" : [
              {
                "key" : "a10:10:0",
                "doc_count" : 1
              },
              {
                "key" : "a10:10:1",
                "doc_count" : 1
              },
              {
                "key" : "a10:10:2",
                "doc_count" : 1
              }
            ]
          }
        },
        {
          "key" : "a100",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 2,
            "buckets" : [
              {
                "key" : "a100:100:1000",
                "doc_count" : 1
              },
              {
                "key" : "a100:100:1001",
                "doc_count" : 1
              },
              {
                "key" : "a100:100:1002",
                "doc_count" : 1
              }
            ]
          }
        },
        {
          "key" : "a1000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 2,
            "buckets" : [
              {
                "key" : "a1000:1000:2000",
                "doc_count" : 1
              },
              {
                "key" : "a1000:1000:2001",
                "doc_count" : 1
              },
              {
                "key" : "a1000:1000:2002",
                "doc_count" : 1
              }
            ]
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 2,
            "buckets" : [
              {
                "key" : "a10000:10000:3000",
                "doc_count" : 1
              },
              {
                "key" : "a10000:10000:3001",
                "doc_count" : 1
              },
              {
                "key" : "a10000:10000:3002",
                "doc_count" : 1
              }
            ]
          }
        }
      ]
    }
  }
}
2. あるフィールド値の合計がある値以上のグループに限定した擬似レコード一覧
GET a_ex/_search?size=0&filter_path=agg*
{
    "aggs": {
        "grp": {
            "terms": {
                "field": "a.keyword"
            },
            "aggs": {
                "c_list": {
                    "terms": {
                        "field": "compl.keyword",
                            "size": 3
                    }
                },
                "the_sum": {
                    "sum": {
                        "field": "b"
                    }
                },
                "my_selection": {
                    "bucket_selector": {
                        "buckets_path": {
                            "p": "the_sum"
                        },
                        "script": "params.p > 5000"
                    }
                }
            }
        }
    }
}
bucket_selectorを使って、合計が5000より大きいグループのみに限定しています。 今回のデータの場合、a10000とa100000のグループのみ抽出されます。
結果
{
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100000",
          "doc_count" : 6,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 3,
            "buckets" : [
              {
                "key" : "a100000:100000:4000",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4001",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4002",
                "doc_count" : 1
              }
            ]
          },
          "the_sum" : {
            "value" : 600000.0
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 2,
            "buckets" : [
              {
                "key" : "a10000:10000:3000",
                "doc_count" : 1
              },
              {
                "key" : "a10000:10000:3001",
                "doc_count" : 1
              },
              {
                "key" : "a10000:10000:3002",
                "doc_count" : 1
              }
            ]
          },
          "the_sum" : {
            "value" : 50000.0
          }
        }
      ]
    }
  }
}
3. 配下件数が多いグループのみ擬似一覧抽出
GET a_ex/_search?size=0&filter_path=agg*
{
    "aggs": {
        "grp": {
            "terms": {
                "field": "a.keyword"
            },
            "aggs": {
                "c_list": {
                    "terms": {
                        "field": "compl.keyword"
                    }
                },
                "count": {
                    "value_count": {
                        "field": "b"
                    }
                },
                "myfilter": {
                    "bucket_selector": {
                        "buckets_path": {
                            "c": "count"
                        },
                        "script": "params.c > 5"
                    }
                }
            }
        }
    }
}
結果
グループ配下のレコード数が5より大のものが抽出されるので、6件レコードがある、a100000グループの配下の6件が抽出されます。
{
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100000",
          "doc_count" : 6,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100000:100000:4000",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4001",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4002",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4003",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:4004",
                "doc_count" : 1
              },
              {
                "key" : "a100000:100000:9999",
                "doc_count" : 1
              }
            ]
          },
          "count" : {
            "value" : 6
          }
        }
      ]
    }
  }
}
4. グループごとにグループ配下の擬似レコードと特定フィールドをペアで抜き出し(sumは実際は1件のレコードの合計なので1つの値を抽出)
おさらい1
complフィールドが実質ユニークなので、そのサブAggsのさらにサブサブAggsで合計を取得すると実際は1件のレコードのあるフィールドの合計つまり値そのものなので、そのような取得を行ってみます。邪道感が増しますが、実質ユニークフィールドに固めた項目以外の項目が欲しい場合とともに、次項のクエリの下敷きの例となっています。
GET a_ex/_search?size=0&filter_path=agg*
{
            "aggs": {
                "grp": {
                    "terms": {
                        "field": "a.keyword"
                    },
                    "aggs": {
                        "c_list": {
                            "terms": {
                                "field": "compl.keyword"
                            },
                            "aggs": {
                                "dValue": {
                                    "sum": {
                                        "field": "d"
                                    }
                                }
                            }
                        }
                    }
                }
            }
        }
結果
{
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100000",
          "doc_count" : 6,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100000:100000:4000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 20.0
                }
              },
              {
                "key" : "a100000:100000:4001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 21.0
                }
              },
              {
                "key" : "a100000:100000:4002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 22.0
                }
              },
              {
                "key" : "a100000:100000:4003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 23.0
                }
              },
              {
                "key" : "a100000:100000:4004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              },
              {
                "key" : "a100000:100000:9999",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              }
            ]
          }
        },
        {
          "key" : "a10",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a10:10:0",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 0.0
                }
              },
              {
                "key" : "a10:10:1",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 1.0
                }
              },
              {
                "key" : "a10:10:2",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 2.0
                }
              },
              {
                "key" : "a10:10:3",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 3.0
                }
              },
              {
                "key" : "a10:10:4",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 4.0
                }
              }
            ]
          }
        },
        {
          "key" : "a100",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100:100:1000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 5.0
                }
              },
              {
                "key" : "a100:100:1001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 6.0
                }
              },
              {
                "key" : "a100:100:1002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 7.0
                }
              },
              {
                "key" : "a100:100:1003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 8.0
                }
              },
              {
                "key" : "a100:100:1004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 9.0
                }
              }
            ]
          }
        },
        {
          "key" : "a1000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a1000:1000:2000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 10.0
                }
              },
              {
                "key" : "a1000:1000:2001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 11.0
                }
              },
              {
                "key" : "a1000:1000:2002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 12.0
                }
              },
              {
                "key" : "a1000:1000:2003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 13.0
                }
              },
              {
                "key" : "a1000:1000:2004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 14.0
                }
              }
            ]
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a10000:10000:3000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 15.0
                }
              },
              {
                "key" : "a10000:10000:3001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 16.0
                }
              },
              {
                "key" : "a10000:10000:3002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 17.0
                }
              },
              {
                "key" : "a10000:10000:3003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 18.0
                }
              },
              {
                "key" : "a10000:10000:3004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 19.0
                }
              }
            ]
          }
        }
      ]
    }
  }
}
5. グループ内であるフィールド値が最大の擬似レコードを抽出(件名に対応した例)
GET a_ex/_search?size=0&filter_path=agg*
{
  "aggs": {
    "grp": {
      "terms": {
        "field": "a.keyword"
      },
      "aggs": {
        "c_list": {
          "terms": {
            "field": "compl.keyword"
          },
          "aggs": {
            "dValue": {
              "sum": {
                "field": "d"
              }
            }
          }
        },
        "max_record": {
          "max_bucket": {
            "buckets_path": "c_list>dValue"
          }
        }
      }
    }
  }
}
結果
max_recordという戻り値フィールドに注目!
{
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100000",
          "doc_count" : 6,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100000:100000:4000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 20.0
                }
              },
              {
                "key" : "a100000:100000:4001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 21.0
                }
              },
              {
                "key" : "a100000:100000:4002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 22.0
                }
              },
              {
                "key" : "a100000:100000:4003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 23.0
                }
              },
              {
                "key" : "a100000:100000:4004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              },
              {
                "key" : "a100000:100000:9999",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              }
            ]
          },
          "max_record" : {
            "value" : 24.0,
            "keys" : [
              "a100000:100000:4004",
              "a100000:100000:9999"
            ]
          }
        },
        {
          "key" : "a10",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a10:10:0",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 0.0
                }
              },
              {
                "key" : "a10:10:1",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 1.0
                }
              },
              {
                "key" : "a10:10:2",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 2.0
                }
              },
              {
                "key" : "a10:10:3",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 3.0
                }
              },
              {
                "key" : "a10:10:4",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 4.0
                }
              }
            ]
          },
          "max_record" : {
            "value" : 4.0,
            "keys" : [
              "a10:10:4"
            ]
          }
        },
        {
          "key" : "a100",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100:100:1000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 5.0
                }
              },
              {
                "key" : "a100:100:1001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 6.0
                }
              },
              {
                "key" : "a100:100:1002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 7.0
                }
              },
              {
                "key" : "a100:100:1003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 8.0
                }
              },
              {
                "key" : "a100:100:1004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 9.0
                }
              }
            ]
          },
          "max_record" : {
            "value" : 9.0,
            "keys" : [
              "a100:100:1004"
            ]
          }
        },
        {
          "key" : "a1000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a1000:1000:2000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 10.0
                }
              },
              {
                "key" : "a1000:1000:2001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 11.0
                }
              },
              {
                "key" : "a1000:1000:2002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 12.0
                }
              },
              {
                "key" : "a1000:1000:2003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 13.0
                }
              },
              {
                "key" : "a1000:1000:2004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 14.0
                }
              }
            ]
          },
          "max_record" : {
            "value" : 14.0,
            "keys" : [
              "a1000:1000:2004"
            ]
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a10000:10000:3000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 15.0
                }
              },
              {
                "key" : "a10000:10000:3001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 16.0
                }
              },
              {
                "key" : "a10000:10000:3002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 17.0
                }
              },
              {
                "key" : "a10000:10000:3003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 18.0
                }
              },
              {
                "key" : "a10000:10000:3004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 19.0
                }
              }
            ]
          },
          "max_record" : {
            "value" : 19.0,
            "keys" : [
              "a10000:10000:3004"
            ]
          }
        }
      ]
    }
  }
}
6. グループごとに配下レコードの特定項目の値の降順に並べて値を取得(前項の「sumは実際は1件だけの合計」方式の応用)
前項はmaxでしたが、こちらは特定のフィールドの値の順序で並べて取得の例です。 (降順にしてあります。ここでは動きを見るために、降順に3件取得にしました。)
GET a_ex/_search?size=0&filter_path=agg*
{
    "aggs": {
        "grp": {
            "terms": {
                "field": "a.keyword"
            },
            "aggs": {
                "c_list": {
                    "terms": {
                        "field": "compl.keyword"
                    },
                    "aggs": {
                        "dValue": {
                            "sum": {
                                "field": "d"
                            }
                        },
                        "orderby": {
                            "bucket_sort": {
                                "sort": [
                                    {
                                        "dValue": {
                                            "order": "desc"
                                        }
                                    }
                                ],
                                    "size": 3
                            }
                        }
                    }
                }
            }
        }
    }
}
結果
{
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100000",
          "doc_count" : 6,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100000:100000:4004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              },
              {
                "key" : "a100000:100000:9999",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              },
              {
                "key" : "a100000:100000:4003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 23.0
                }
              }
            ]
          }
        },
        {
          "key" : "a10",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a10:10:4",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 4.0
                }
              },
              {
                "key" : "a10:10:3",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 3.0
                }
              },
              {
                "key" : "a10:10:2",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 2.0
                }
              }
            ]
          }
        },
        {
          "key" : "a100",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100:100:1004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 9.0
                }
              },
              {
                "key" : "a100:100:1003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 8.0
                }
              },
              {
                "key" : "a100:100:1002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 7.0
                }
              }
            ]
          }
        },
        {
          "key" : "a1000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a1000:1000:2004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 14.0
                }
              },
              {
                "key" : "a1000:1000:2003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 13.0
                }
              },
              {
                "key" : "a1000:1000:2002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 12.0
                }
              }
            ]
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a10000:10000:3004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 19.0
                }
              },
              {
                "key" : "a10000:10000:3003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 18.0
                }
              },
              {
                "key" : "a10000:10000:3002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 17.0
                }
              }
            ]
          }
        }
      ]
    }
  }
}
7. レコードの特定項目の値が特定の値以上のものを取得(グループごとに分類あり)
GET a_ex/_search?size=0&filter_path=agg*
{
            "aggs": {
                "grp": {
                    "terms": {
                        "field": "a.keyword"
                    },
                    "aggs": {
                        "c_list": {
                            "terms": {
                                "field": "compl.keyword"
                            },
                            "aggs": {
                                "dValue": {
                                    "sum": {
                                        "field": "d"
                                    }
                                },
                                "myfilter": {
                                    "bucket_selector": {
                                        "buckets_path": {
                                            "d": "dValue"
                                        },
                                        "script": "params.d >= 11"
                                    }
                                }
                            }
                        }
                    }
                }
            }
        }
結果
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100000",
          "doc_count" : 6,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a100000:100000:4000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 20.0
                }
              },
              {
                "key" : "a100000:100000:4001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 21.0
                }
              },
              {
                "key" : "a100000:100000:4002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 22.0
                }
              },
              {
                "key" : "a100000:100000:4003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 23.0
                }
              },
              {
                "key" : "a100000:100000:4004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              },
              {
                "key" : "a100000:100000:9999",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 24.0
                }
              }
            ]
          }
        },
        {
          "key" : "a10",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [ ]
          }
        },
        {
          "key" : "a100",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [ ]
          }
        },
        {
          "key" : "a1000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a1000:1000:2001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 11.0
                }
              },
              {
                "key" : "a1000:1000:2002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 12.0
                }
              },
              {
                "key" : "a1000:1000:2003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 13.0
                }
              },
              {
                "key" : "a1000:1000:2004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 14.0
                }
              }
            ]
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "c_list" : {
            "doc_count_error_upper_bound" : 0,
            "sum_other_doc_count" : 0,
            "buckets" : [
              {
                "key" : "a10000:10000:3000",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 15.0
                }
              },
              {
                "key" : "a10000:10000:3001",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 16.0
                }
              },
              {
                "key" : "a10000:10000:3002",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 17.0
                }
              },
              {
                "key" : "a10000:10000:3003",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 18.0
                }
              },
              {
                "key" : "a10000:10000:3004",
                "doc_count" : 1,
                "dValue" : {
                  "value" : 19.0
                }
              }
            ]
          }
        }
      ]
    }
  }
}
8. 複合クエリも可能
GET a_ex/_search?size=0&filter_path=agg*
{
    "aggs": {
        "grp": {
            "terms": {
                "field": "a.keyword"
            },
            "aggs": {
                "c_list": {
                    "terms": {
                        "field": "compl.keyword"
                    },
                    "aggs": {
                        "dValue": {
                            "sum": {
                                "field": "d"
                            }
                        },
                        "f": {
                            "bucket_sort": {
                                "sort": [
                                    { "dValue": { "order": "desc" } }
                                ],
                                    "size": 3
                            }
                        }
                    }
                },
                "count": {
                    "value_count": {
                        "field": "b"
                    }
                },
                "myfilter": {
                    "bucket_selector": {
                        "buckets_path": {
                            "c": "count"
                        },
                        "script": "params.c > 5"
                    }
                }


            }
        }
    }
}
Elasticsearch のPipeline aggregationsのさわり
ElasticsearchのPipeline aggregationsは、ElasticsearchでSQLのHavingっぽいことが可能になるしかけです*1。
これまた品揃えが豊富で、今確認したら、20種類近くあるようですが、次のBucket aggregationsや Metrics aggregationsの記事と同じ論法(シンタックスが似ているAggregationは、似た挙動となるのでまとめて覚えると一度に覚える負担が減る論法!)でPipelineについてもおなじように本記事でまとめてみました。
- 事前準備:
- 1.各バケットでの集計値を見るAggs
- 2. max_bucketなどと同様にbuckets_pathを指定するが累積型の挙動なので親バケットに条件ありAggs
- 3. ソートする(sort)
- 4. bucket_scriptとbucket_selector
- その他のPipeline aggregations
※この記事を書くにあたり、Elasticsearchのバージョンは6.8で確認しました。
事前準備:
この類の話はサンプルデータがあると理解が進みます。
次の過去記事の最初のセクション記載の手順でa_exインデックスを作成ください。
1.各バケットでの集計値を見るAggs
Pipleline aggsのうち、入力に数値を取り扱い、必須プロパティがbuckets_pathでかつ大外のaggsにぶら下げるタイプのもの一覧です。
他に紛れているとわかりづらいですが、こうして抜き出してみると、名前だけで何をしてくれるかなんとなく分かりますね(?)。
このシリーズの例によって(?)、シンタックスのエッセンスをあぶり出す意図で、JSONを扱いやすいJavaScriptの簡易コードを通して、シンタックスを説明します。
a_exインデックスに対して、上記を全部盛りしたクエリを標準出力に出力する、JavaScriptの例は次のとおりです。
// Pipeline aggregationsは前段階の別のAggregationsにのっかることになりますが、その土台のクエリです。
const bucp = 'grp>the_sum';
const base_query = {
    "size": 0,
    "aggs": {
        "grp": {
            "terms": {
                "field": "a.keyword"
            },
            "aggs": {
                "the_sum": {
                    "sum": {
                        "field": "b"
                    }
                }
            }
        }
    }
};

// Pipleline aggsのうち、入力に数値を取り扱い、必須プロパティがbuckets_pathでかつ大外のaggsにぶら下げるタイプのもの一覧
const plagg_names = [
    "max_bucket",
    "min_bucket",
    "sum_bucket",
    "stats_bucket",
    "extended_stats_bucket",
];

const bp1 = (plagg_name, buckets_path) => { // buckets_pathは複数階層の場合、「aaa > bbb」のようなパンくず風に指定する。
    return {
        [plagg_name]: {
            buckets_path
        }
    }
};

// (もちろん1つずつ使えますが)比較のため全てのaggsを一度に実行するクエリを生成します。
plagg_names.forEach(pln => {
    base_query.aggs[`my_${pln}`] = bp1(pln, bucp);
});

console.log(JSON.stringify(base_query));
上記を実行して得られるElasticsearchの生クエリは次のものです。
GET a_ex/_search
{
  "size": 0,
  "aggs": {
    "grp": {
      "terms": {
        "field": "a.keyword"
      },
      "aggs": {
        "the_sum": {
          "sum": {
            "field": "b"
          }
        }
      }
    },
    "my_max_bucket": {
      "max_bucket": {
        "buckets_path": "grp>the_sum"
      }
    },
    "my_min_bucket": {
      "min_bucket": {
        "buckets_path": "grp>the_sum"
      }
    },
    "my_sum_bucket": {
      "sum_bucket": {
        "buckets_path": "grp>the_sum"
      }
    },
    "my_stats_bucket": {
      "stats_bucket": {
        "buckets_path": "grp>the_sum"
      }
    },
    "my_extended_stats_bucket": {
      "extended_stats_bucket": {
        "buckets_path": "grp>the_sum"
      }
    }
  }
}
これは、先のa_exに対して、フィールドaの登録値で、Bucket Agg(値でグループ化)して、グループ内のbフィールド値の合計をMetrics Agg(のsum)で計算したバケットが得られているところに対し、「max_bucket」でグループごとの合計が最も多いグループを抜き出す、最も少ない(min_bucket)グループを抜き出す、... というクエリ例になっています。
なお、buckets_pathに、grp>the_sumと目印が指定されていますが、これはクエリの上の方の、grpとその配下のthe_sumに至るパスを示すことで、Aggregation結果を参考にmax_bucket等を行いなさいという命令になっているととらえて良いでしょう。
ということでこれの実行結果です。↓
{
  "aggregations" : {
    "grp" : {
      "buckets" : [
        {
          "key" : "a10",
          "doc_count" : 5,
          "the_sum" : {
            "value" : 50.0
          }
        },
        {
          "key" : "a100",
          "doc_count" : 5,
          "the_sum" : {
            "value" : 500.0
          }
        },
        {
          "key" : "a1000",
          "doc_count" : 5,
          "the_sum" : {
            "value" : 5000.0
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "the_sum" : {
            "value" : 50000.0
          }
        },
        {
          "key" : "a100000",
          "doc_count" : 5,
          "the_sum" : {
            "value" : 500000.0
          }
        }
      ]
    },
    "my_max_bucket" : {
      "value" : 500000.0,
      "keys" : [
        "a100000"
      ]
    },
    "my_min_bucket" : {
      "value" : 50.0,
      "keys" : [
        "a10"
      ]
    },
    "my_sum_bucket" : {
      "value" : 555550.0
    },
    "my_stats_bucket" : {
      "count" : 5,
      "min" : 50.0,
      "max" : 500000.0,
      "avg" : 111110.0,
      "sum" : 555550.0
    },
    "my_extended_stats_bucket" : {
      "count" : 5,
      "min" : 50.0,
      "max" : 500000.0,
      "avg" : 111110.0,
      "sum" : 555550.0,
      "sum_of_squares" : 2.525252525E11,
      "variance" : 3.81596184E10,
      "std_deviation" : 195344.87042151886,
      "std_deviation_bounds" : {
        "upper" : 501799.7408430377,
        "lower" : -279579.7408430377
      }
    }
  }
}
2. max_bucketなどと同様にbuckets_pathを指定するが累積型の挙動なので親バケットに条件ありAggs
以下のとおり、前項のmax_bucketと単品のクエリシンタックスは似ていますが、cumulattiveとかderivativeという名のとおり、親バケット(上位のグループ化)が産まれながらに順序性を持つことになるhistogram系Aggバケットが前提になっており、言い換えると親バケットにぶら下げる形でクエリを作るという点でも前項とやや異なります。
const bp2 = {
    "cumulative_sum": {
        "buckets_path": "aggname"
    }
}

const bp3 = {
    "derivative": {
        "buckets_path": "aggname"
    }
}

// X-Pack
const bp4 = {
    "cumulative_cardinality": {
        "buckets_path": "aggname"
    }
}
実際のクエリ例
GET a_ex/_search
{
  "size": 0,
  "aggs": {
    "adh": {
      "date_histogram": {
        "field": "date",
        "interval": "1D"
      },
      "aggs": {
        "the_sum": {
          "sum": {
            "field": "b"
          }
        },
        "cumsum": {
          "cumulative_sum": {
            "buckets_path": "the_sum"
          }
        },
        "derv": {
          "derivative": {
            "buckets_path": "the_sum"
          }
        }
      }
    }
  }
}
derivativeの例はエラーにはならなかったというレベルの例になっていますが、cumsumは累積和になっていることがよくわかる応答が戻ってきます。
3. ソートする(sort)
集計というよりは、バケット一覧をソートします。
ぶら下げたAggのバケット一覧を特定の条件で並び替えます。
* シンタックス例(の擬似表現)
const sort = {
    "bucket_sort": {
        "sort": [
            { "aggname1": { "order": "asc" } },
            { "aggname2": { "order": "desc" } },
        ],
        "from": 1,
        "size": 3
    }
}
* 実際のクエリ例
GET a_ex/_search
{
  "size": 0,
  "aggs": {
    "grp": {
      "terms": {
        "field": "a.keyword"
      },
      "aggs": {
        "the_sum": {
          "sum": {
            "field": "b"
          }
        },
        "the_avg": {
          "avg": {
            "field": "b"
          }
        },
        "my_max_bucket": {
          "bucket_sort": {
            "sort": [
              {
                "the_avg": {
                  "order": "desc"
                }
              },
              {
                "the_sum": {
                  "order": "desc"
                }
              }
            ],
            "from": 1,
            "size": 3
          }
        }
      }
    }
  }
}
この例だと旨味を感じにくいですが、フィールドaの値でグループ分けし、バケットのbフィールドのグループ内の合計の降順、バケットのbフィールドのグループ平均の降順の優先度で得られたMetrix Aggregationバケットの一覧をソートしています。
4. bucket_scriptとbucket_selector
Painless scriptで同じ階層のAggregationで得られた値を変数に見立てて、新たな演算を行ったり(bucket_script)、条件にマッチするもののみフィルター(bucket_selector)します。
ビルトインのままでは難しいものはこちらで頑張るという選択肢を広げてくれますね。
擬似シンタックス表現はこちら↓。
// シンタックスはよく似ています。

//  同じ並びのaggsの値を使って、さらに別の計算値を取得します。script部分で計算式を指定します。
//  ここでは、バケットごとのあるフィールドの合計値をバケット内の要素数で割って、平均値を取得する例です。
//   (この例であれば、わざわざPipeline aggsを使わなくとも、Metrics aggsのavgで十分ですが、あえてそちらと同じ結果をPipeline aggsで得るという例としました)

const script = {
    "bucket_script": {
        "buckets_path": {
            "v1": "the_sum",
            "v2": "the_count"
        },
        "script": "params.v1 / params.v2"
    }
}

// 同じ並びのaggsの値を使って、条件に合致したもののみを取得します。script部分で条件判定の式を指定します。
const select = {
    "bucket_selector": {
        "buckets_path": {
            "v1": "the_max",
            "v2": "the_min"
        },
        "script": "params.v1 > params.v2 * 2"
    }
}
*クエリ例
実際のクエリ例です。script(自前で平均(avg)を計算)とselector(グループ内の合計が件数の11倍より多いもののみ残す(=このデータ例だとフィールドaが「a10」のデータが脱落)を両方実施しています。
GET a_ex/_search
{
  "size": 0,
  "aggs": {
    "grp": {
      "terms": {
        "field": "a.keyword"
      },
      "aggs": {
        "the_sum": {
          "sum": {
            "field": "b"
          }
        },
        "the_count": {
          "value_count": {
            "field": "b"
          }
        },
        "custom_avg": {
          "bucket_script": {
            "buckets_path": {
              "var1": "the_sum",
              "var2": "the_count"
            },
            "script": "params.var1 / params.var2"
          }
        },
        "custom_selection":{
            "bucket_selector": {
            "buckets_path": {
              "var1": "the_sum",
              "var2": "the_count"
            },
            "script": "params.var1 >  params.var2 * 11"
          }

        }
      }
    }
  }
}
結果イメージ
{
  "aggregations" : {
    "grp" : {
      "doc_count_error_upper_bound" : 0,
      "sum_other_doc_count" : 0,
      "buckets" : [
        {
          "key" : "a100",
          "doc_count" : 5,
          "the_count" : {
            "value" : 5
          },
          "the_sum" : {
            "value" : 500.0
          },
          "custom_avg" : {
            "value" : 100.0
          }
        },
        {
          "key" : "a1000",
          "doc_count" : 5,
          "the_count" : {
            "value" : 5
          },
          "the_sum" : {
            "value" : 5000.0
          },
          "custom_avg" : {
            "value" : 1000.0
          }
        },
        {
          "key" : "a10000",
          "doc_count" : 5,
          "the_count" : {
            "value" : 5
          },
          "the_sum" : {
            "value" : 50000.0
          },
          "custom_avg" : {
            "value" : 10000.0
          }
        },
        {
          "key" : "a100000",
          "doc_count" : 5,
          "the_count" : {
            "value" : 5
          },
          "the_sum" : {
            "value" : 500000.0
          },
          "custom_avg" : {
            "value" : 100000.0
          }
        }
      ]
    }
  }
}
その他のPipeline aggregations
だいぶ俯瞰できた気でいましたが、他にもまだまだありますが、(心の声)解説がむずかしそうなので、別の機会に。 (movingとあるので、移動平均とかこの類の要件の次のレベルのものたちだと思います。そこをとっかかりに理解を深めると良いのではと思います。> 筆者自分自身向け)
自分メモ:それぞれの擬似シンタックス俯瞰表現↓
const avgb = {
    // tag::avg-bucket-agg-syntax[]
    "avg_bucket": {
        "buckets_path": "sales_per_month>sales",
        "gap_policy": "skip",
        "format": "#,##0.00;(#,##0.00)"
    }
    // end::avg-bucket-agg-syntax[]
}

const sd = {
    "serial_diff": {
        "buckets_path": "the_sum",
        "lag": 7
    }
}

const mva = the_sum => ({
    "moving_avg": {
        "buckets_path": the_sum,
        "model": "holt",
        "window": 5,
        "gap_policy": "insert_zeros",
        "settings": {
            "alpha": 0.8
        }
    }
})

const mvf = the_sum => ({
    "moving_fn": {
        "buckets_path": the_sum,
        "window": 10,
        "script": "MovingFunctions.min(values)"
    }
})

const mvp = the_percentile => ({
    "moving_percentiles": {
        "buckets_path": "the_percentile",
        "window": 10
    }
})

const inference = {
    "inference": {
        "model_id": "a_model_for_inference",
        "inference_config": {
            "regression_config": {
                "num_top_feature_importance_values": 2
            }
        },
        "buckets_path": {
            "avg_cost": "avg_agg",
            "max_cost": "max_agg"
        }
    }
}
*1:ただし、あくまで親や同列のAggs結果に作用するものです
ElasticsearchのBucket aggregationsのさわり
ElasticsearchのAggregationsは種類が豊富ゆえに、嬉しい悲鳴なのですが、私のようなメモリが小さい人間はどれがどれというところの理解が大変です。
実際は、似た演算は、クエリの形とパラメータ、得られるバケット(演算結果)の形式が似ているので、同じような用途の内容違いのものを形から入って理解しましょうということで、記事をまとめてみました。
今回は、Bucket aggregatios、Metrics ...、Pipeline ...、でいうところのBucket aggregationsの俯瞰照会です。
- 事前準備:サンプルデータのインポート
- 1.時系列バケット(date系)
- 2.数値範囲(ヒストグラム的)バケット
- 3. geo系バケット
- 4. terms(特定フィールドの値で分類)系バケット
- 5. filters
- 6. adjacency_matrix
- 7. filter
- 8. sampler
- 9. significant_terms(とsignificant_text)
- 10. 機会があれば(残りのもの一覧)
事前準備:サンプルデータのインポート
クエリの説明用に、a_ex というインデックスにデータをインポートします。 他の方法でもかまいませんが、ここではkibanaにペタペタ貼り付け想定で示しています。
mapping設定
PUT a_ex/
{
  "mappings": {
    "mapping": {
      "properties": {
        "date": {
          "type": "date"
        },
        "loc": {
          "type": "geo_point"
        }
      }
    }
  }
}
データ(25件)のPOST
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}, "date": "2021-07-01"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a100", "b": 100, "c": 200, "weight": 2, "loc": {"lat": 35.5, "lon": 145.2}, "date": "2021-07-02"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a1000", "b": 1000, "c": 2000, "weight": 3, "loc": {"lat": 35.5, "lon": 145.3}, "date": "2021-07-03"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a10000", "b": 10000, "c": 20000, "weight": 4, "loc": {"lat": 35.5, "lon": 145.4}, "date": "2021-07-04"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
POST a_ex/_doc/
{"a": "a100000", "b": 100000, "c": 200000, "weight": 5, "loc": {"lat": 35.5, "lon": 145.5}, "date": "2021-07-05"}
1.時系列バケット(date系)
- auto_date_histogram
- date_histogram
- date_range
まずは、時系列バケット。 キラーコンテンツならぬキラークエリですね。
Date系タイプのフィールドを指定して、それをグループにしたバケット分類します。
そのグループや刻み方のオプションによって何種類かあります。
並べてみると相対化されてわかりやすくなる(と思う)のですが、
というものになっているようです。
同列に語れるものは3種類あり、これを仕様を見比べしやすいように、JavaScriptのアロー関数で擬似的にシンタックスの要点を示したものが次のものです。 (似た形のものをまとめて、かつ対比することで、具体的な説明を見なくとも、名前から何ができるかなんとなくわかりません? 今回は対比することで察しやすくなるよね、という考えで、具体的な説明は極力省かせてもらっています。)
const date = field => ({
    "aggs": {
        "my_num": {
            "auto_date_histogram": {
                field,
                "buckets": 10
                //, "format": "yyyy-MM-dd"
            }
        },
        "my_interval": {
            "date_histogram": {
                field,
                "calendar_interval": "2d"
            }
        },
        "my_range": {
            "date_range": {
                field,
                "format": "MM-yyyy",
                "ranges": [
                    { "from": "01-2015", "to": "03-2015", "key": "quarter_01" },
                    { "from": "03-2015", "to": "06-2015", "key": "quarter_02" }
                ],
                "keyed": true
            }
        }
    }
})
実際に、上記の一つを試してみます。
注:私の手元のElasticsearch 6.8では、7系から対応のcalender_intervalパラメータには対応しておらず、deprecatedなintervalパラメータで代用しています。7系でcalender_interval対応後のバージョンをご利用の方は下記例についてご注意ください。
GET a_ex/_search
{
  "size": 0,
  "aggs": {
    "my_interval": {
      "date_histogram": {
        "field": "date",
        "interval": "1d"
      }
    }
  }
}
結果
{
  "aggregations" : {
    "my_interval" : {
      "buckets" : [
        {
          "key_as_string" : "2021-07-01T00:00:00.000Z",
          "doc_count" : 5
        },
        {
          "key_as_string" : "2021-07-02T00:00:00.000Z",
          "doc_count" : 5
        },
        {
          "key_as_string" : "2021-07-03T00:00:00.000Z",
          "doc_count" : 5
        },
        {
          "key_as_string" : "2021-07-04T00:00:00.000Z",
          "doc_count" : 5
        },
        {
          "key_as_string" : "2021-07-05T00:00:00.000Z",
          "doc_count" : 5
        }
      ]
    }
  }}
2.数値範囲(ヒストグラム的)バケット
- variable_width_histogram
- histogram
- range
日付を巡る要件と数値(お金など)の階級化・グループ化は似たものが多いですね。 ということで、数値の値によるバケットのグループ化に対応するのが、rangeやhistogramアグリゲーションです。 こころなしか、時系列系と品揃えが似ていますね。
以下、JavaScriptのアロー関数で擬似的にシンタックスの要点です。
const hist = field => ({
    "aggs": {
        // variable_width_histogramが使えるのは7.9あたりから
        /*
        "my_num": {
            "variable_width_histogram": {
                field,
                "buckets": 2
            }
        },
        */
        "my_interval": {
            "histogram": {
                field,
                "interval": 5
            }
        },
        "my_range": {
            "range": {
                field,
                "ranges": [
                    { "to": 100.0 },
                    { "from": 100.0, "to": 200.0 },
                    { "from": 200.0 }
                ]
            }
        }
    }
})
実際のクエリイメージ(histogram)
GET a_ex/_search
{
  "size": 0,
  "aggs": {
    "my_interval": {
      "histogram": {
        "field": "b",
        "interval": "1000"
      }
    }
  }
}
3. geo系バケット
- geohash_grid
- geotile_grid
- geo_distance
時系列と数値の間ほどではありませんが、 座標(GEO)系にも似た要件が発生することが多いような気がしますが、それらにも対応しているようです。
geohashとグループ化の精細度のようなもの、geotileとグループ化の精細度のようなもの および geo_distacneとrangesの3種類ですね。
以下、JavaScriptのアロー関数で擬似的にシンタックスの要点です。
なお、クエリイメージと結果は割愛します。実際に試す場合は、最初に登録したデータのlocフィールドを使ってください。
const geo = field => ({
    "aggs": {
        "my_geohashGrid": {
            "geohash_grid": {
                field,
                "precision": 3
            }
        },
        "my_geotileGrid": {
            "geotile_grid": {
                field,
                "precision": 8
            }
        },
        "my_geoDistance": {
            "geo_distance": {
                field,
                "origin": "52.3760, 4.894",
                "ranges": [
                    { "to": 100000 },
                    { "from": 100000, "to": 300000 },
                    { "from": 300000 }
                ]
            }
        }
    }
})
4. terms(特定フィールドの値で分類)系バケット
- terms
- rare_terms
これはシンプルな例ですね。 特定のフィールドの値に応じて分類。 いわゆるカテゴリデータ的なものでのグループ分類。
説明順が真ん中あたりになりましたが、私見では、Bucket Aggsで一番最初にお世話になるのは、termsアグリゲーションではないでしょうか。
以下、JSアロー関数での擬似説明。
const aggByFieldVal = field => ({
    "aggs": {
        "vals": {
            "terms": { field }
        },
        /* ver 7系から対応(ver 6系では未対応)
        "rareVals": {
            "rare_terms": { field, max_doc_count:1 }
        }
        */

    }
})
5. filters
バケットの分類条件を検索クエリで指定しようというのがfilters。
他のBucket Aggregations でもそのようなものがないわけではないのですが、あるドキュメントが、複数のバケット両方でカウントされるということも可能です。
const filters = {
    "size": 0,
    "aggs": {
        "messages": {
            "filters": {
                "filters": {
                    "overRank1": { "prefix": { "a.keyword": "a10" } },
                    "onlyOverRank2": { "prefix": { "a.keyword": "a1000" } }
                }
            }
        }
    }
}
6. adjacency_matrix
あらかじめ定義したカギとなる分類条件(検索クエリ風の記法・条件で指定)のうち、同時に当てはまったものの組み合わせ自体をバケット分類基準とするのがadjacency_matrix。 ただし、マトリックスという名のとおり、どれか一つに当てはまるもの、同時に2つの条件に当てはまるものに分類されるので、3つの条件を設定すると、最大で3 + (3 * 2 )/2 = 6バケットに分類されます。
前項のfiltersと似ていますね。
filtersだと無意味に難しくなるような例に対してもっと宣言的にバケット分類できると言えるような気がするが、そこそこリアルでかつメリットを示しやすい良い例が思い当たらないところが悩ましい。
注:以下の例は、最初にインポートした例とは噛み合っていません。(公式Rの例が一番わかりやすいと思います。)
// 全体クエリで示しています。
const adj = {
    "size": 0,
    "aggs": {
        "interactions": {
            "adjacency_matrix": {
                "filters": {
                    "grpA": { "terms": { "accounts": ["hillary", "sidney"] } },
                    "grpB": { "terms": { "accounts": ["donald", "mitt"] } },
                    "grpC": { "terms": { "accounts": ["vladimir", "nigel"] } }
                }
            }
        }
    }
}
7. filter
filtersではなくて、filterです。
クエリで絞り込まなくても、絞り込みしたバケットを形成できる。 下記のようにアパレルの売り上げ平均とTシャツのみの売り上げ平均を比べてみるといった例に便利そうですし、 aggsを組み合わせなくとも、単純にこの分類のみのバケットをみてみたい...という使い方もそれなりに使えそうですね。
形から入る本記事ではこの場所になりましたが、実際は、termsと同じぐらいよく使われるAggsで、ゆえに理解は難しくないように思います。
// 全体クエリで示しています。

const filter = field => ({
    "size":0,
    "aggs": {
        "avg_price": { "avg": { field } },
        "t_shirts": {
            "filter": { "term": { "type": "t-shirt" } },
            "aggs": {
                "avg_price": { "avg": { field } }
            }
        }
    }
})
8. sampler
samplerは、shard数を指定して(つまりある程度shardを絞って)、バケット分類のある種の精度を落としつつその分、レスポンス確保するためのヒント的なaggsです。
分類というよりは、比較的ヘビーな処理であるAggregationsを近似的に行うための命令と思って良いでしょう。
const sampler = field => ({
    "aggs": {
        "sample": {
            "sampler": {
                "shard_size": 10
            },
            "aggs": {
                // value_countはちょっと変な組み合わせだが、やってることが分かる。
                "vc": {
                    "value_count": {
                        field
                    }
                }
            }
        }
    }
})
9. significant_terms(とsignificant_text)
このブログでは何度かでてます、significant_terms(とsignificant_text)。
const sig = (filterField, field) => ({
    "aggs": {
        "siggrp": {
            "terms": { "field": filterField },
            "aggs": {
                "sig": {
                    "significant_terms": { field }
                }
            }
        }
    }
})
10. 機会があれば(残りのもの一覧)
ver 7.13のX-packを除いたBucket Aggregationsとしては他に次のようなものがあります。 これらはまた別途。 (ここまでご紹介したものと、形はだいぶ異なる...ということだけお伝えしておきます。)
- global
- nested
- reverse_nested
ElasticsearchのMetrics aggregationsのさわり
ElasticsearchのMetrics aggregationsは、その名の通り?統計的なAggregationsです。
機能充実はありたがたいもののその分だけ数も多いですね。
それぞれの名称、SQLや他の言語などでの関数名と類似性から、得られる値や使い方は同じような用法だろうなーと推測はされるものの、実際必要になるまでは試す気にもならずということで私自身も食わず嫌いではあるのですが、見た目から入って入門するというのが良いのではと思い、ちょいと変則的な切り口でまとめてみました... という記事です。
Metrics aggregationsのよくある「型」
さっそくですが、Metrics aggregationsらは、つまるところ集計関数です。
QueryDSLで得られた検索結果ドキュメント一覧に対して、なんらかの集計などを行います。
集計を行うからには、当然対象のフィールドをどれか指定することになり、おそらく数値型のフィールドを指定することになるでしょう。
実際、集計クエリの形としては、(全部ではありませんが)次のようなものになるものが大半です。
{
        aggs: {
            [agg_label]: {
                [AGGNAME]: {
                    field: fieldname,
                }
            }
        }
}
クエリの種類数は多いですが、上記の見た目をとるものについては、fieldnameで指定されるフィールドに対し、AGGNAMEで示す統計的演算を施す...と見れば一網打尽ではないでしょうか。
現に、X-Packが必要ないもののうちで、AGGNAMEに指定できるものは次のようなものとなっています。
value_count,avg,max,min,sum,stats,extended_stats,cardinality,percentiles,median_absolute_deviation
名前だけで分からないものもありますが、agv、max,sum ...などという顔ぶれを見ればなんとなくわかったような気がしてきます。
では、次に上記にいろいろ当てはめて、試してみましょう。
試してみる
試してみましょうと言いましたが、実際のところ、上記のヒトたちは、名前と形から予想される動作となります。
よって、ひとつずつ試してみるというよりは、同じ形になるというところを示唆することも兼ねて、kibanaにコピペしやすいクエリ一覧をアドホックに出力するスニペットのご紹介で代用することにします。
データ登録用のポストデータ出力
import json

ii = [10, 100, 1000, 10000,100000]

a = []

num = 5

for i, v in enumerate(ii):
    idx = i + 1
    x = [{'a':'a'+str(v),'b':v, 'c': v * 2, 'weight':idx,'loc':{'lat':35.5,'lon':float('145.'+str(idx))}} for _ in range(num) ]
    a.extend(x)

for i in a:
    print('POST a_ex/_doc/')
    print(json.dumps(i, ensure_ascii=False))
などとすると下記が出力されます。
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}}
POST a_ex/_doc/
{"a": "a10", "b": 10, "c": 20, "weight": 1, "loc": {"lat": 35.5, "lon": 145.1}}
POST a_ex/_doc/
 ...
a_exが今回お試し用のインデックスです。
あとで平均などの集計を行う際に、得られる値が予測しやすいようにラフな規則の値をPOSTすることをイメージした出力にしてあります。
逆にいうと、ここで登録するデータはなんらかのドメインとは全く関係ありませんので、数値傾向自体は何も意味をなさないことに注意ください。
なお今回は、locフィールドは使っていません。主に、bフィールドを練習に使います。
上記の出力をkibanaにコピペすると、データ登録されます。今回は明示的なmapping設定は行いません(ひとまず不要です)。
検索(aggsクエリ発行)
前項で登録したデータ(インデックス)をターゲットに、特にbフィールドを意識した、同じ形のクエリ一覧を生成します。 (例によって、直接クエリを発行するのではなく、kibanaに貼り付け用の例を出力する方式です。)
const h = _ => console.log('GET a_ex/_search?filter_path=agg*');

const aggs1 = (AGGNAME, fieldname) => {
    const agg_label = `my_${AGGNAME}`;
    return {
        aggs: {
            [agg_label]: {
                [AGGNAME]: {
                    field: fieldname,
                }
            }
        }
    };
};


AGGNAMES1 = 'value_count,avg,max,min,sum,stats,extended_stats,cardinality,percentiles,median_absolute_deviation'.split(',');

AGGNAMES1.forEach(a => {
    const f = 'b';
    //console.log('GET a_ex/_search?filter_path=agg*');
    h();
    console.log(JSON.stringify(aggs1(a, f)));
});


matstats = fields => {
    return {
        size: 0,
        aggs: {
            "mtrx_stats": {
                matrix_stats: {
                    fields
                }
            }
        }
    }
};

h();
console.log(JSON.stringify(matstats(['b', 'c'])));

const pr = (field, values) => ({
    size: 0,
    aggs: {
        "my_percentile_ranks": {
            percentile_ranks: {
                field,
                values,
            }
        }
    }
});

h();
console.log(JSON.stringify(pr('b', [10, 1000])));

const wg = (f1, f2) => ({
    // Σ (value * weight)/Σ(weight)
    size: 0,
    aggs: {
        "my_weighted_avg": {
            weighted_avg: {
                value: {
                    field: f1
                },
                weight: {
                    field: f2
                }
            }
        }
    }
});

h();
console.log(JSON.stringify(wg('b', 'idx')));
上記はJavaScriptのプログラムですが、例えば下記のように実行してください。
node fuga.js
あとは、kibanaでポチポチ実際に実行してみれば確かにそうだね...という感じの結果が得られます。
これを、先ほどのインデックスデータを登録した環境のkibanaでポチポチ実行してみてください。
先の話のとおり、この類の分野に慣れている方なら、ああ確かにこうなのねという結果が得られるのえですが、自分メモとして、上記の中では少しだけクセがある演算について以下のとおり、ひとこと補足しておきます。
- stats: avgやmaxなどの主要な基本統計量を一括で取得
- extended_stats: statsのさらに拡張
- median_absolute_deviation: いわゆるMADが取得できる(とのこと)
また、次は、複数パラメータを取る分、少しだけaggsクエリの形が違うのでやや別枠としましたが、本質的には、似た種類に属するので合わせてご紹介してあります。
- matrix_stats: 複数フィールドを指定すると、フィールド間の共分散等が取得できる。それ以外にももともと各フィールドのstatsおよび歪度と尖度が得られるので、指定フィールドを1つだけにしてこの数値を取得する命令と考えても良いかもシレナイ。
- percentile_ranks: 指定した数値が累積パーセンタイルのどこに属するかを表してくれる。
- weighted_avg: 各レコードの集計フィールドに対して、指定の別フィールドの値を重みとみなした平均
その他
Metrics aggregationsのうち、X-Pack以外のもので、残りは次のものです。 こちらは時間があればまた。
- top_hits
- geo_bounds
- geo_centroid
自作の照合型ソートのスニペット例(JavaScriptでもmapやreduce、filter(手習いメモ) その4)
JavaScriptのmapやreduceは実用言語っぽい挙動で自分のようなぬる者にはありがたいよね〜のシリーズの第4弾です。
といいつつ、ある素材について、いざやってみるとfilterやreduceはおろか、メインロジック部分あたりではmapさえも使わなかったので、実際は、filterやreduceでおしゃれにコーディングできそうな雰囲気があるテーマについて、筆者の棋力ではそうはならなかったけど、そこそこスニペットとして面白かったので、公開してみました...という読み替えでお願いします。
とりあつかっているもの
- 漢字表記とカナ読みの固有名詞的なワードの組み合わせがあり、カナでない部分に読みを当てたトークンを生成
- 自作の照合型ソートの例
1がこりゃ面白いかもと思って始めたものの力技(というかナイーブな例)になってしまったので、記事にするには不足かなと思って、2も対応してみましたが、手グセで、2の方もナイーブな例となりました。 (ですが、書捨てるには惜しい気がしたので自分メモとして残しています。)
1. 漢字表記とカナ読みの固有名詞的なワードの組み合わせがあり、カナでない部分に読みを当てたトークンを生成
コード例
'use strict';

const a = 'ブラックJARKSニ世露死苦メカドッグ'.split('');
const bStr = 'ブラックジャックスニヨロシクメカドッグ';
const k = 0x30A1;
const kana = [...Array(92).keys()].map(i => String.fromCodePoint(k + i));
//const hiragana = [...Array(86).keys()].map(i => String.fromCodePoint(0x3041 + i));
console.log(kana);
const isKana = c => kana.includes(c);

const tokenize = a => {
    let c = a.shift();
    let p = c;
    const s = [p];
    while (a.length > 0) {
        c = a.shift();
        s.push(
            (isKana(c) && !isKana(p))
                || (!isKana(c) && isKana(p))
                ? ',' + c
                : c
        );
        p = c;
    }
    return s.join('').split(',');
};

const tokens = tokenize(a);

const getReadingForm = (tokens, bStr) => {
    const k2k = {};
    let str = bStr;
    for (let i = 0; i < tokens.length; i++) {
        const t = tokens[i];
        const kanaTknStsPos = str.indexOf(t);
        if (kanaTknStsPos < 0) {
            continue;
        }
        if (kanaTknStsPos === 0) {
            str = str.slice(t.length);
            continue;
        }
        const kanjiYomi = str.slice(0, kanaTknStsPos);
        k2k[tokens[i - 1]] = kanjiYomi;
        str = str.slice(kanaTknStsPos + t.length);
    }
    return k2k;
}

console.log(getReadingForm(tokens, bStr));
実行結果
{ JACKS: 'ジャックス', '世露死苦': 'ヨロシク' }
漢字と読み(例では変数 aとbStr)を前の方から比較して、同じカナが現れるまでは漢字(やアルファベットなど)と読みのペアとみなして、走査するイメージです。
ある前提のもと、diffっぽいことをナイーブなやり方で実施するイメージでしょうか。
2. 自作の照合型ソートの例
実際は難しいことはしておらず、Array.sort関数に、照合表で勝ち負けを参照しながら、並びを判定する関数を引き渡しして実現します。
'use strict';

const collationfunc = (a, b) => {
    const co = [...'abcdefghijklmnopqrstuvwxy'].reverse();  //照合用の配列。zはあえて無し。
    console.log(co);
    const ia = co.findIndex(e => e === a);
    const ib = co.findIndex(e => e === b);
    //どちらも存在しない場合は昇順
    if (ia === -1 && ib === -1) return a > b ? 1 : -1;
    //一方が存在しなければ、もう一方の存在する方の勝ち
    if (ia === -1) return 1;
    if (ib === -1) return -1;
    //照合の優先度が高い方が勝ち
    if (ia > ib) return 1;
    if (ia < ib) return -1;
};

const sorted = ['a', 'b', 'g', 'd', 'z', 'zzzz', 'f'].sort(collationfunc);

console.log(sorted);

/*

↓ 期待値イメージ

zをのぞく1文字アルファベットは降順。それ以外(zとzzzz)は最後尾となりこの2つの間はアルファベットの昇順。
[
 'g','f','d','b','a','z','zzzz'
]
*/
